Tạo game bằng AI: Claude làm game soulslike Three.js trong 3 ngày nhờ Dream Loop
Tạo game bằng AI thế nào? Meng To dùng Claude Fable 5.2 làm game soulslike Three.js trong 3 ngày. Sáu bước, Dream Loop, chấm mù, thử ở căn cứ mặt trăng.
Tạo game bằng AI, để game "chơi được" giờ không còn khó nữa; cái khó thật sự là làm cho nó "đẹp". Bạn bảo AI chỉnh ánh sáng tốt hơn một chút, làm hiệu ứng hoành tráng hơn một chút, lần nào nó cũng nói đã sửa xong, nhưng bạn nhìn không ra là có đẹp hơn thật không, cũng không nói được khác ở chỗ nào.
Meng To, nhà sáng lập Design+Code và Aura, gần đây chia sẻ trên X một game Three.js phong cách soulslike: làm xong trong ba ngày bằng Claude Fable 5.2, chạy thẳng trên trình duyệt, có đủ ánh sáng, hiệu ứng và âm thanh, thậm chí không có bước build nào. Anh ấy giải thích toàn bộ quy trình trong một chuỗi bài đăng (thread gốc) và đã mở mã nguồn các skill mình dùng trên GitHub, nhưng không công khai đầy đủ các prompt. Bài này mình mổ xẻ sáu bước của anh ấy, tập trung vào chiêu giúp hình ảnh cứ đẹp dần lên là Dream Loop, cuối bài mình cũng thử thật một lần với căn cứ mặt trăng trên trang chủ website của mình.
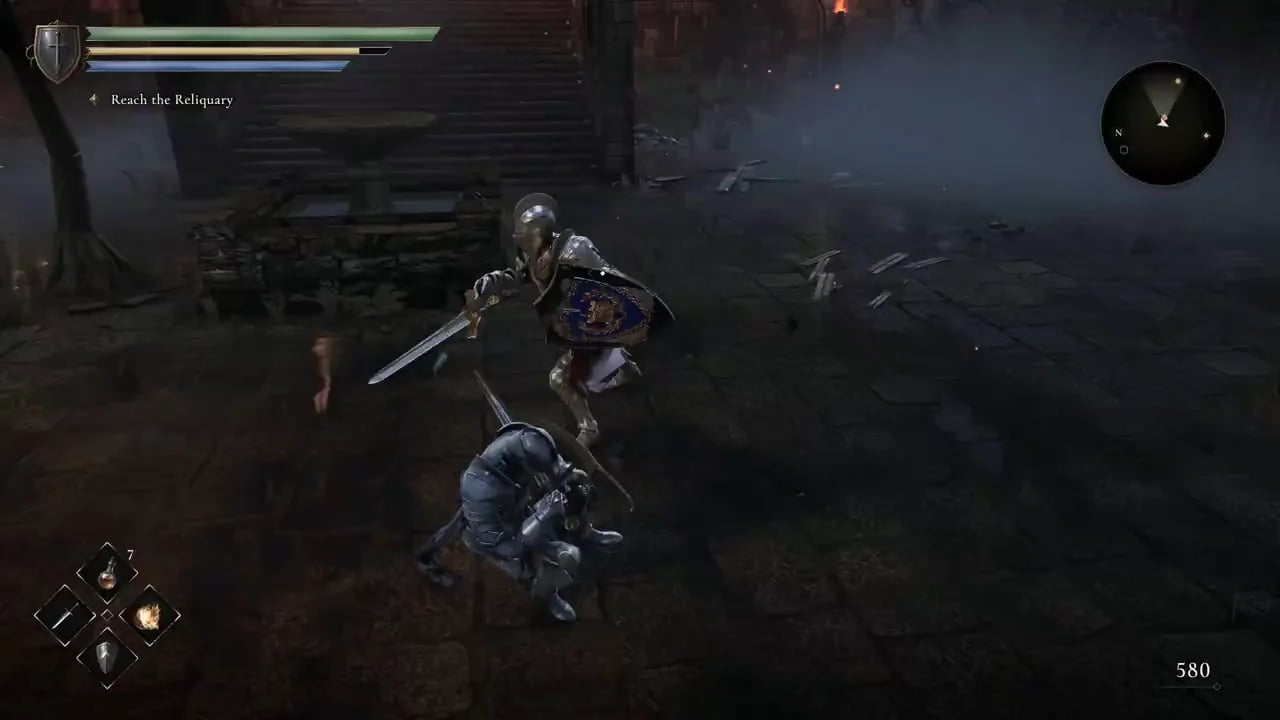
Làm game bằng Claude Code cần những công cụ gì?
Bộ công cụ anh ấy liệt kê chỉ có bốn thứ:
- Claude Code: dùng Fable 5.2 làm chủ lực, kèm Opus 5.5 chạy các tác vụ con.
- Three.js: 3D thuần web, không đóng gói build, chạy thẳng trên trình duyệt.
- Seedream 5.0 Pro: tạo ảnh bằng AI, vẽ concept art nhân vật, icon giao diện, và quan trọng nhất là "ảnh mục tiêu".
- Tripo 3D: chuyển concept art thành mô hình 3D.
Bản thân các công cụ không có gì lạ, điều đáng học là cách anh ấy nối chúng thành một vòng lặp tự cải thiện.
Bước 1: Làm cho game chơi được trước đã
Bước đầu tiên chỉ có một mục tiêu: làm ra một phiên bản chơi được. Anh ấy đưa cho Fable 5.2 một prompt, đồng thời cho nó nạp ba skill: dream-loop được người khác công khai mã nguồn, cộng với hai skill tự viết, một cái lo quy trình "chấm điểm so với mục tiêu", một cái lo thiết kế chiến đấu hành động (đều nằm trong kho Skills của anh ấy).
Sau sáu tiếng và mười hai prompt, đã có một màn chơi đi được, đánh được và một con boss. Lúc này hình ảnh đẹp hay không chưa quan trọng, trước hết phải cho lối chơi chạy thông suốt đã.
Bước 2: Chia việc cho nhiều AI agent
Sau khi chơi được, anh ấy để Fable 5.2 làm tổng chỉ huy, mở nhiều luồng con Opus 5.5, mỗi luồng phụ trách một mảng: ánh sáng, hiệu ứng, nhân vật, đạo cụ, giao diện, âm thanh. Tối đa chín luồng cùng lúc, mỗi luồng chỉ sửa đúng các file mình phụ trách.
Quy tắc cuối này rất quan trọng. Nhiều AI cùng sửa một dự án cùng lúc thì chuyện hay xảy ra nhất là ghi đè lên nhau; ai lo file nấy thì chín luồng mới thật sự chạy song song được.
Âm thanh là ngoại lệ. Anh ấy nói trong phần bình luận rằng AI hiện nay tổng hợp hiệu ứng âm thanh bằng code vẫn còn rất tệ, nên chuyển sang dùng thư viện âm thanh của mình, rồi nối vào bằng skill earshot.
Bước 3: Tạo game 3D bằng AI: vẽ concept art rồi chuyển thành mô hình
Quy trình cho nhân vật và quái vật là:
- Seedream vẽ concept art với điều kiện rất chặt: tư thế chữ A chuẩn, nền xám.
- Tripo 3D chuyển concept art thành mô hình GLB, cả game dùng tổng cộng 29 mô hình.
- Mô hình xuất ra không có khung xương, khung xương và hoạt ảnh đều để AI viết thẳng bằng code.
Tư thế chữ A và nền xám là để ảnh dễ chuyển sang 3D: tay tách khỏi thân thì mới không bị dính thành một khối, nền sạch thì mới không bị lưu bóng đổ vào texture. Mình cũng gặp đúng vấn đề này trong bài "Thử nghiệm dựng mô hình 3D bằng AI" và "Cách kiểm tra mô hình Tripo AI": concept art chuẩn bị không tốt thì về sau sửa kiểu gì cũng rất cực.
Theo lời anh ấy, mọi prompt và tài nguyên đều nằm trên một canvas Fil, nhìn qua là biết bản concept nào thành mô hình nào. Nhưng trong chuỗi bài anh ấy chỉ đăng ảnh chụp màn hình của canvas đó; bản thân canvas không được công khai, nên không xem được đầy đủ các prompt.
Bước 4: Dream Loop là gì?
Đây là chỗ thông minh nhất của cả quy trình.
- Chụp một tấm ảnh màn hình game.
- Bảo Seedream vẽ lại ảnh chụp đó, prompt yêu cầu camera, bố cục, cách sắp đặt, tư thế nhân vật giữ nguyên hoàn toàn, chỉ cần vẽ đẹp hơn.
- Ảnh vẽ lại này chính là "ảnh mục tiêu", rồi cho các AI agent sửa ánh sáng, chất liệu, hiệu ứng cho đến khi hình ảnh trong game tiến gần tới nó.
Tại sao lại hiệu quả? Vì "làm hình đẹp hơn chút nữa" là một câu không thể nghiệm thu được, còn một ảnh mục tiêu cùng góc camera thì có thể đem ra so trực tiếp: bóng ở góc tường đã đủ đậm chưa, ánh sáng ngoài cửa sổ có hắt vào không, sàn có phản chiếu không, đều nhìn ra được hết. AI cuối cùng cũng có một hướng cụ thể để đuổi theo.
Đá, bình gốm, vật liệu đá trong cảnh, anh ấy dùng tài nguyên quét 3D CC0 miễn phí của Poly Haven, không phải thứ gì cũng phải để AI tạo.
Thử nghiệm của mình: chạy Dream Loop với căn cứ mặt trăng
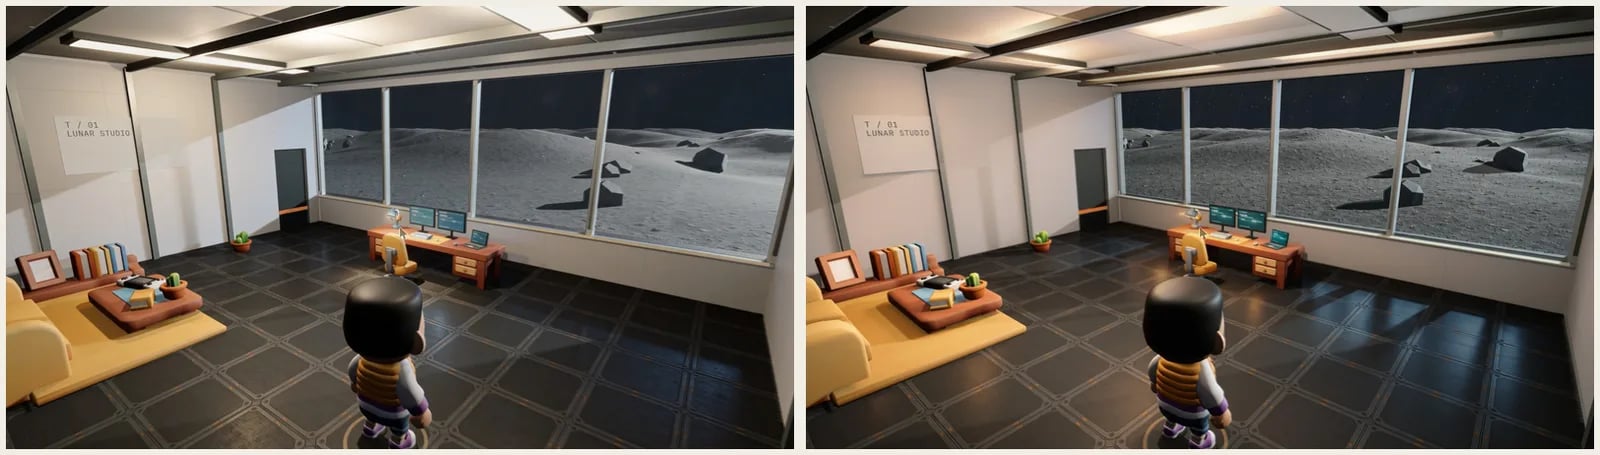
Mình lấy phòng làm việc trên mặt trăng ở trang chủ website của mình ra thử. Đây là một cảnh làm bằng Three.js, nhân vật chính Terry đứng giữa phòng, ngoài cửa sổ là bề mặt mặt trăng.
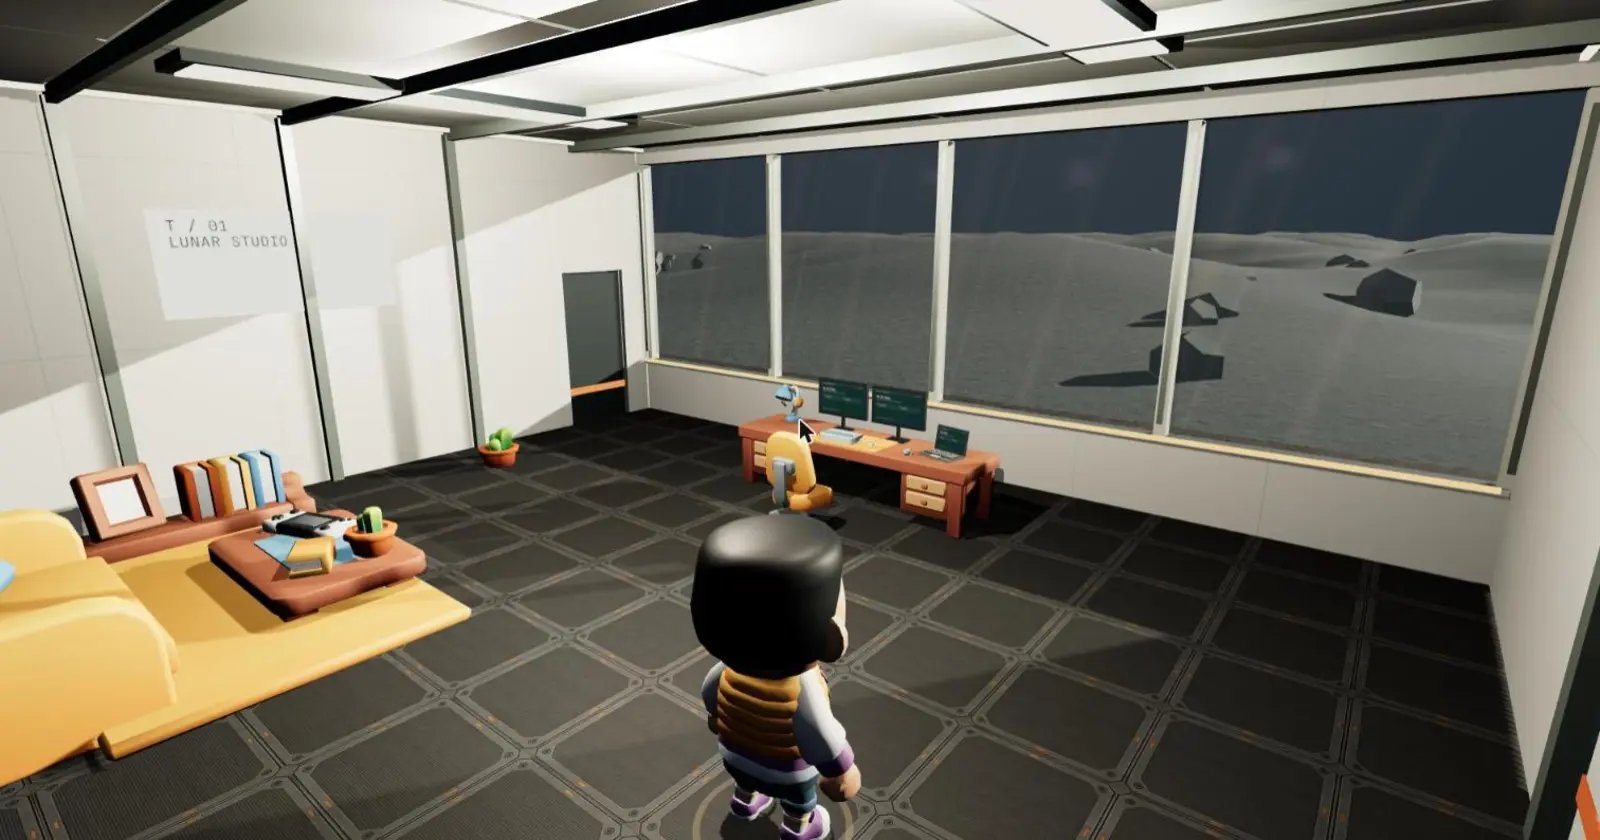
Mình dùng tính năng tạo ảnh của ChatGPT (gpt-image) để vẽ lại ảnh chụp này, ý chính của prompt giống Meng To, chia làm hai phần:
- Giữ nguyên hoàn toàn: vị trí camera, góc nhìn, bố cục, vị trí và số lượng của từng đồ vật, tư thế và phong cách chibi của nhân vật, cấu trúc căn phòng, bảng màu. Mình ghi rõ là không được chuyển sang phong cách tả thực.
- Chỉ đổi phần render: thêm ambient occlusion ở góc tường và dưới đồ nội thất, ánh sáng ấm trong phòng, ánh trăng lạnh từ ngoài cửa sổ chiếu xiên vào, màn hình phát sáng nhẹ, gạch lát sàn hơi bóng, hố va chạm trên mặt trăng ngoài cửa sổ rõ hơn, bầu trời có sao, thêm chút bloom và vignette.
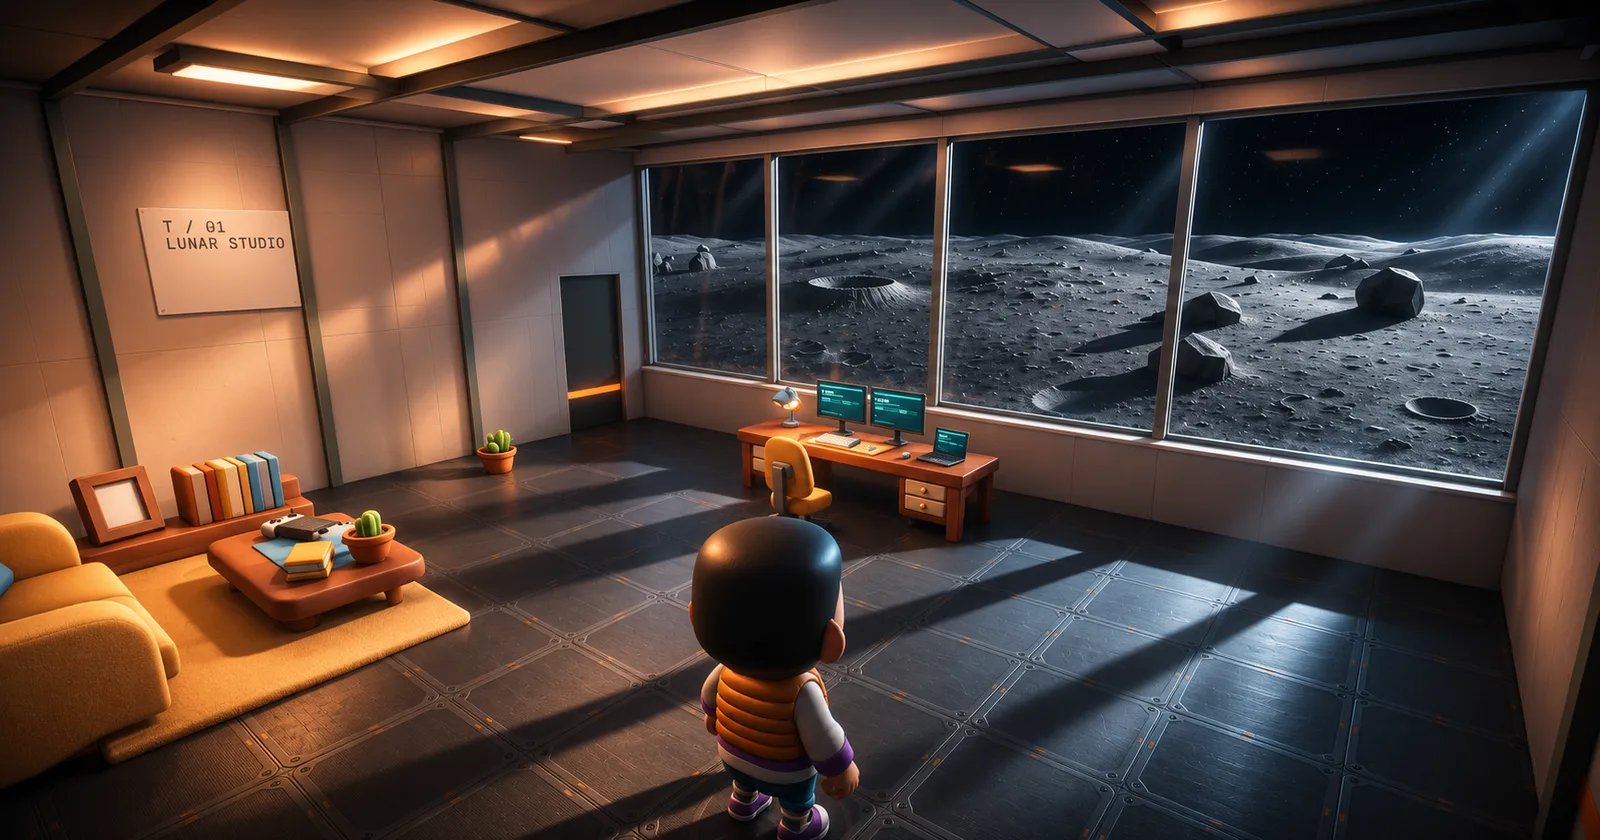
Ngay lần đầu đã thấy được hướng đi: góc tường có bóng, ánh sáng cửa sổ kéo thành từng dải trên sàn, mặt trăng từ một mảng xám biến thành địa hình có hố, có đá. Đây đều là những thứ mình có thể nói thẳng với AI "sửa theo như này".
Nhưng cũng thấy được vấn đề: góc camera bị mở rộng ra một chút, bàn làm việc cũng nhỏ đi. Mình đã ghi rõ là không được động vào camera, vậy mà mô hình tạo ảnh vẫn lén đổi bố cục. Muốn dùng tấm này làm ảnh mục tiêu thì phải kiểm tra trước xem nó có sửa những chỗ không được sửa hay không; đây cũng là lý do bước giám khảo tiếp theo quan trọng đến vậy.
Seedream và gpt-image khác nhau ở đâu?
Meng To dùng Seedream để vẽ ảnh mục tiêu, còn lần đầu mình dùng gpt-image. Để so cho rõ, sau đó mình chụp lại một tấm mới, cùng một ảnh chụp, cùng một đoạn prompt, đưa cho Seedream 5.5 và gpt-image, mỗi bên vẽ một lần. Meng To dùng Seedream 5.0 Pro, còn mình dùng bản 5.5 mới hơn: khi thử thì rẻ hơn, mà độ chính xác đã đủ để khớp đến từng pixel. Điều mình quan tâm không phải bên nào vẽ đẹp hơn, mà là bên nào giữ bố cục tốt hơn, vì đó chính là thứ Dream Loop cần nhất.
Prompt lần này chặt hơn lần đầu rất nhiều: ghi rõ bố cục phải khớp từng pixel, mọi đồ vật và đường viền không được xê dịch, và chỉ được thêm những hiệu ứng mà Three.js render thời gian thực làm được, như ánh sáng, bóng đổ, chất liệu, bloom, không được vẽ ra thứ mà game engine không làm nổi.
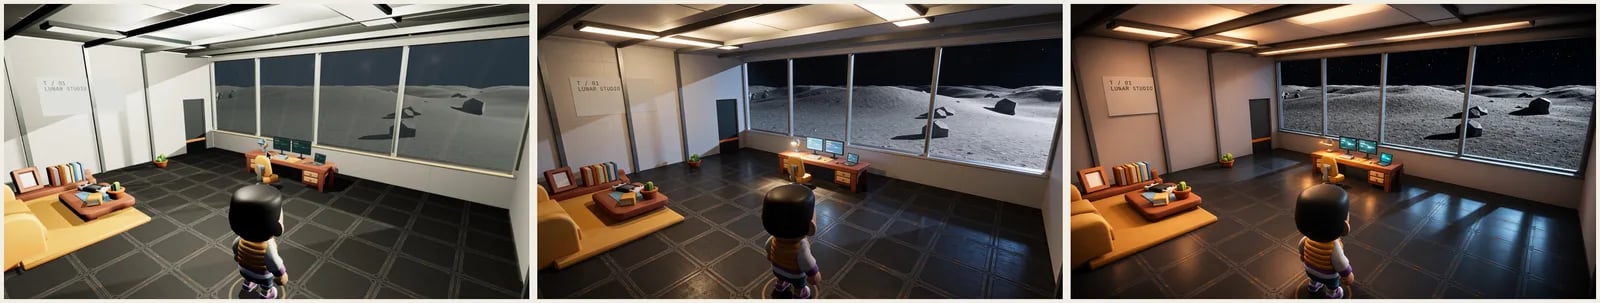
Cả hai đều đẹp hơn ảnh gốc rất nhiều, nhưng mỗi bên một phong cách:
- Seedream 5.5 thiên lạnh, thiên tả thực: mặt trăng vừa sáng vừa rõ, sàn có phản chiếu, tổng thể giống một trạm không gian thật.
- gpt-image thiên ấm, không khí đậm: đèn trần ấm hơn, bầu trời sao dày hơn, ánh sáng cửa sổ kéo thành dải rõ rệt trên sàn.
Khác biệt thật sự chỉ lộ ra khi chồng ảnh vẽ lại lên ảnh gốc:
- Seedream 5.5 gần như khớp từng pixel: chồng lên gần như không thấy bóng ma, khung cửa sổ, bàn, nhân vật đều nằm đúng chỗ cũ.
- gpt-image gần đúng nhưng hơi lệch: vị trí đại thể đều đúng, nhưng đường viền của trần nhà và khung cửa sổ lệch nhẹ. Ngay cả gpt-image vẽ xong cũng tự báo lại là "bố cục gần giống, nhưng không khớp từng pixel".
Seedream cũng không thành công ngay lần đầu. Lần đầu nó xuất thẳng ra một ảnh vuông, kéo dài khung hình lên trên và xuống dưới, bố cục lại toàn bộ; mình cắt ảnh đầu vào thành 16:9 rồi chỉ định tỷ lệ đầu ra, lần thứ hai mới khớp. Nên dù dùng bên nào, tỷ lệ đầu vào và đầu ra phải nói rõ từ trước.
Kết luận của mình: để làm ảnh mục tiêu cho Dream Loop thì Seedream dễ dùng hơn, vì các AI agent đuổi theo chi tiết ở từng vị trí, bố cục lệch một chút là đuổi công cốc. gpt-image hợp để tìm hướng, xem thử "có thể tạo ra cảm giác như thế nào". Dù dùng bên nào, ảnh mục tiêu nhất định phải chồng lên ảnh chụp gốc so một lần, không khớp thì vẽ lại.
Bước 5: Giao diện cũng để AI vẽ
Giao diện game anh ấy gần như không viết prompt gì nhiều, đại khái là:
- Trước tiên nhờ nó ra concept art cho cả bộ giao diện, gồm cả thanh máu, thanh thể lực ở dưới màn hình.
- Bảo nó làm theo đó.
- Chê chưa đủ chất, thì yêu cầu viền có thêm gradient, độ bất quy tắc, bóng đổ và cảm giác nhiễu hạt.
- Cuối cùng xin icon dạng PNG nền trong suốt.
Icon cũng là PNG nền trong suốt do Seedream vẽ.
Bước 6: Mỗi lần sửa đều chấm mù
Đây là mấu chốt giúp Dream Loop không bị mất kiểm soát. Quy tắc của anh ấy là:
- Mỗi lần thay đổi, đều chụp một tấm 4K trước khi sửa và một tấm sau khi sửa ở cùng một góc camera.
- Giao cho một giám khảo AI hoàn toàn mới, hai ảnh bị xáo thứ tự, chỉ đánh dấu là X và Y, giám khảo không biết tấm nào là mới.
- Chỉ khi bản mới thắng hoặc hòa thì lần sửa đó mới được giữ lại.
- Một vòng đầy đủ dùng hai giám khảo, một bảng chấm thang 10, lấy điểm thấp hơn, mục tiêu là 9 điểm.
AI agent rất giỏi nói "tôi sửa xong rồi", nhưng tự sửa rồi tự nghiệm thu thì thường càng sửa càng lệch. Đổi sang một giám khảo chưa từng thấy quá trình, lại xáo thứ tự, chẳng khác gì làm regression test cho chất lượng hình ảnh, những lần sửa làm hình xấu đi sẽ không được giữ lại.
Lệnh anh ấy tự gõ cũng rất ngắn, đại ý là "cứ sửa đến khi được 8 điểm", "lần nào cũng gửi mình ảnh trước và sau khi sửa, hoạt ảnh thì gửi video". Có lần hiệu ứng chém của boss sửa mãi không xong, câu trả lời của anh ấy đã lộ rõ sự mất kiên nhẫn; xem ra quy trình xịn đến đâu thì vẫn có lúc bị kẹt.
Giới hạn của phương pháp này
Chính Meng To cũng nói rất rõ, đây chưa phải là một game hoàn chỉnh:
- Trong video là bot chạy theo kịch bản đang chơi, mỗi cảnh đều được sắp đặt trước.
- Giám khảo khó tính phần lớn chỉ cho 5 đến 6 điểm, còn rất xa mới tới 9.
- Thời gian tải hơn 10 giây.
- Hoạt ảnh đi bộ và chạy là khó nhất, anh ấy nói trong phần bình luận đã thử ít nhất 8 lần, riêng đi bộ bị anh ấy loại 4 lần.
Vậy nên thứ làm ra trong ba ngày là một bản demo chơi được, chưa phải game có thể phát hành. Nhưng với một người làm game một mình, từ con số không lên được mức này chỉ trong ba ngày đã là rất đáng nể.
Tự làm game bằng AI một mình thì nên học chiêu nào trước?
Nếu bạn cũng đang làm game bằng AI, mình nghĩ có ba điều đáng mang về dùng trước nhất:
- Dùng một tấm ảnh để định nghĩa "đẹp": chụp màn hình, vẽ lại, lấy làm mục tiêu, chính xác hơn nhiều so với viết một đoạn dài mô tả phong cách.
- Để người khác nghiệm thu: chụp trước và sau khi sửa cùng một góc camera, giao cho một AI mới chọn mù, đừng để người sửa tự chấm điểm.
- Một tổng chỉ huy dẫn nhiều agent chuyên trách: mỗi agent chỉ đụng vào file của mình, mới yên tâm chạy song song.
Bước tiếp theo của mình là theo tấm ảnh mục tiêu trong thử nghiệm để sửa ánh sáng phòng làm việc trên mặt trăng, mỗi lần sửa lại chụp một cặp ảnh trước và sau cho giám khảo chọn, xem có thật sự tiến sát được tấm ảnh đó không.
Bạn đã từng thử để AI tự đánh giá xem hình ảnh có đẹp hơn chưa? Cứ ghé Threads hoặc X để lại bình luận dưới bài đăng của mình, cùng trò chuyện nhé.