Yapay Zeka ile Oyun Yapma: Claude ile 3 Günde Souls-like Oyun ve Dream Loop
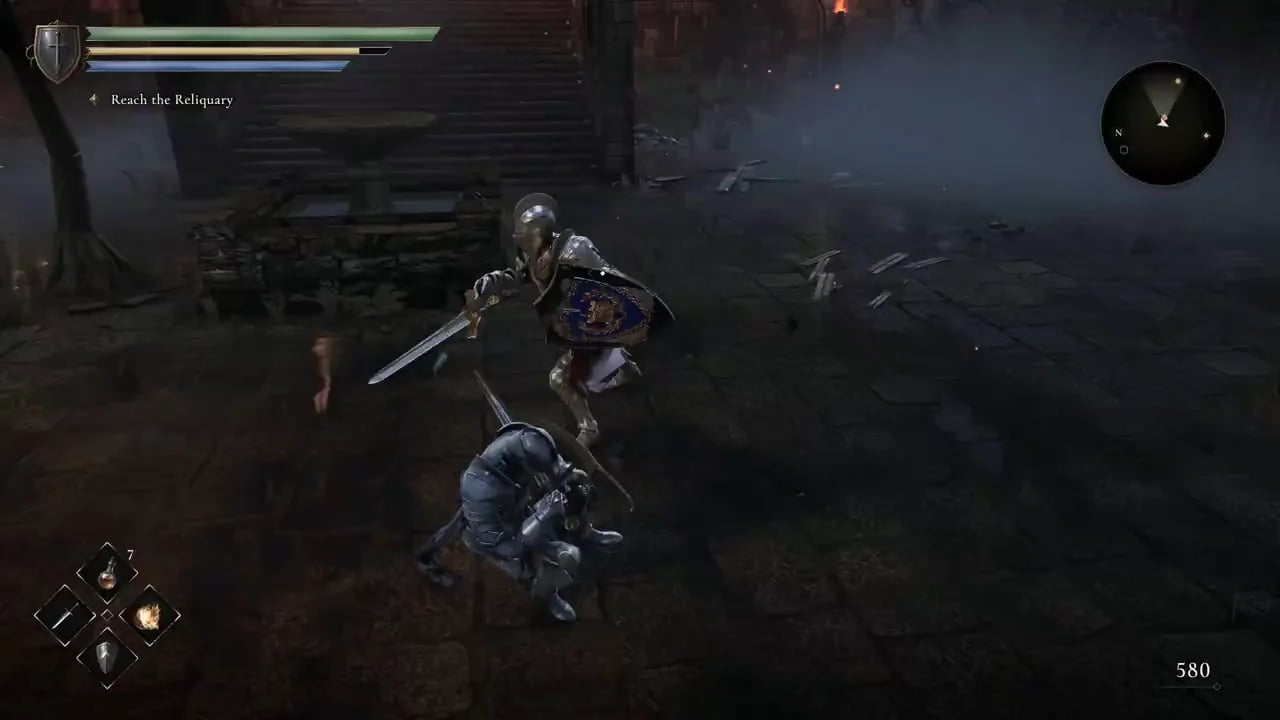
Yapay zeka ile oyun yapma örneği: Meng To, Claude Fable 5.2 ile 3 günde souls-like bir Three.js oyunu yaptı. Altı adım, Dream Loop ve ay üssünde denemem.
Yapay zeka ile oyun yaparken oyunu "oynanabilir" hale getirmek artık zor değil; asıl zor olan onu "güzel göstermek". Yapay zekadan ışıklandırmayı biraz düzeltmesini, efektleri biraz daha gösterişli yapmasını istiyorsunuz; her seferinde "düzelttim" diyor ama gerçekten daha iyi olup olmadığını göremiyorsunuz, farkın nerede olduğunu da söyleyemiyorsunuz.
Design+Code ve Aura'nın kurucusu Meng To geçenlerde X'te souls-like tarzda bir Three.js oyunu paylaştı: Claude Fable 5.2 ile üç günde bitmiş, doğrudan tarayıcıda çalışıyor, tam ışıklandırması, efektleri ve sesleri var, üstelik hiçbir build adımı yok. Tüm iş akışını bir gönderi dizisinde anlatıyor (orijinal flood) ve kullandığı skill'leri GitHub'da açık kaynak olarak paylaşmış, ancak tam prompt'larını yayımlamamış. Bu yazıda onun altı adımını parça parça inceliyorum; ağırlığı, görüntüyü sürekli daha iyiye götüren numaraya, yani Dream Loop'a veriyorum. Sonunda da kendi sitemin ana sayfasındaki ay üssünde bir kez denedim.
Claude ile oyun yapmak: hangi araçlar kullanıldı?
Paylaştığı set sadece dört parçadan oluşuyor:
- Claude Code: Ana model Fable 5.2, alt görevleri Opus 5.5 çalıştırıyor.
- Three.js: Saf web 3D; paketleme ya da build yok, doğrudan tarayıcıda çalışıyor.
- Seedream 5.0 Pro: Yapay zekayla görsel üretimi; karakter konsept çizimleri, arayüz ikonları ve en önemlisi "hedef görsel".
- Tripo 3D: Konsept çizimlerini 3D modele çeviriyor.
Araçların kendisi çok sıra dışı değil; öğrenmeye değer olan, bunları kendi kendine iyileşen bir döngüye nasıl bağladığı.
Adım 1: Önce oyunu oynanabilir yapın
İlk adımın tek bir hedefi var: oynanabilir bir sürüm çıkarmak. Fable 5.2'ye bir prompt verip aynı anda üç skill yüklemesini sağlamış: başkasının açık kaynak olarak yayımladığı dream-loop ve kendi yazdığı iki skill. Bunlardan biri "hedefe göre puanlama" iş akışını, diğeri aksiyon dövüş tasarımını üstleniyor (ikisi de onun Skills deposunda).
Altı saat ve on iki prompt sonra elinde yürünebilen, dövüşülebilen bir bölüm ve bir boss vardı. Bu aşamada görüntünün güzel olup olmaması önemli değil; önce oynanışın baştan sona çalışması gerekiyor.
Adım 2: İşi birden fazla yapay zeka ajanına bölün
Oyun oynanabilir hale gelince Fable 5.2'yi şef yapıyor ve birkaç Opus 5.5 alt iş parçacığı açıyor; her biri bir alandan sorumlu: ışıklandırma, efektler, karakterler, objeler, arayüz, ses. Aynı anda en fazla dokuz tane çalışıyor ve her biri yalnızca kendi sorumlu olduğu dosyaları değiştiriyor.
Bu son kural çok önemli. Birden fazla yapay zeka aynı projeyi aynı anda değiştirdiğinde en sık yaşanan sorun birbirinin işinin üzerine yazmak; herkes kendi dosyalarına baktığında dokuz iş parçacığı gerçekten paralel çalışabiliyor.
Ses bunun istisnası. Yorumlarda, bugünkü yapay zekaların kodla ses efekti sentezlemede hâlâ çok kötü olduğunu söylüyor; bu yüzden kendi ses kütüphanesine geçmiş ve bunu earshot skill'iyle bağlamış.
Adım 3: Yapay zeka ile 3D oyun yapma: önce konsept çizimi, sonra model
Karakter ve canavarların akışı şöyle:
- Seedream konsept çizimini yapıyor, şartlar çok katı: standart A-pozu, gri arka plan.
- Tripo 3D konsept çizimini GLB modele çeviriyor; oyunda toplam 29 tane var.
- Çıkan modellerin iskeleti yok; iskelet ve animasyonları yapay zekaya doğrudan kodla yazdırıyor.
A-pozu ve gri arka plan, görselin 3D'ye dönüşümünü kolaylaştırmak için: kollar gövdeden ayrı durursa birbirine yapışmıyor, arka plan temiz olursa gölgeler dokuya gömülmüyor. Ben de "Yapay zeka ile 3D modelleme denemesi" ve "Tripo AI modelleri nasıl kontrol edilir" yazılarımda aynı sorunla karşılaştım: konsept çizimi iyi hazırlanmazsa sonradan ne kadar düzeltseniz de çok zahmetli oluyor.
Söylediğine göre tüm prompt'lar ve varlıklar tek bir Fil tuvalinde duruyor; hangi konsept çizimin hangi modele dönüştüğü bir bakışta görülüyor. Ancak dizide yalnızca bu tuvalin ekran görüntüsünü paylaşmış; tuvalin kendisi herkese açık değil, bu yüzden tam prompt'ları göremiyoruz.
Adım 4: Dream Loop nedir?
Tüm sürecin en zekice kısmı burası.
- Önce oyundan bir ekran görüntüsü alın.
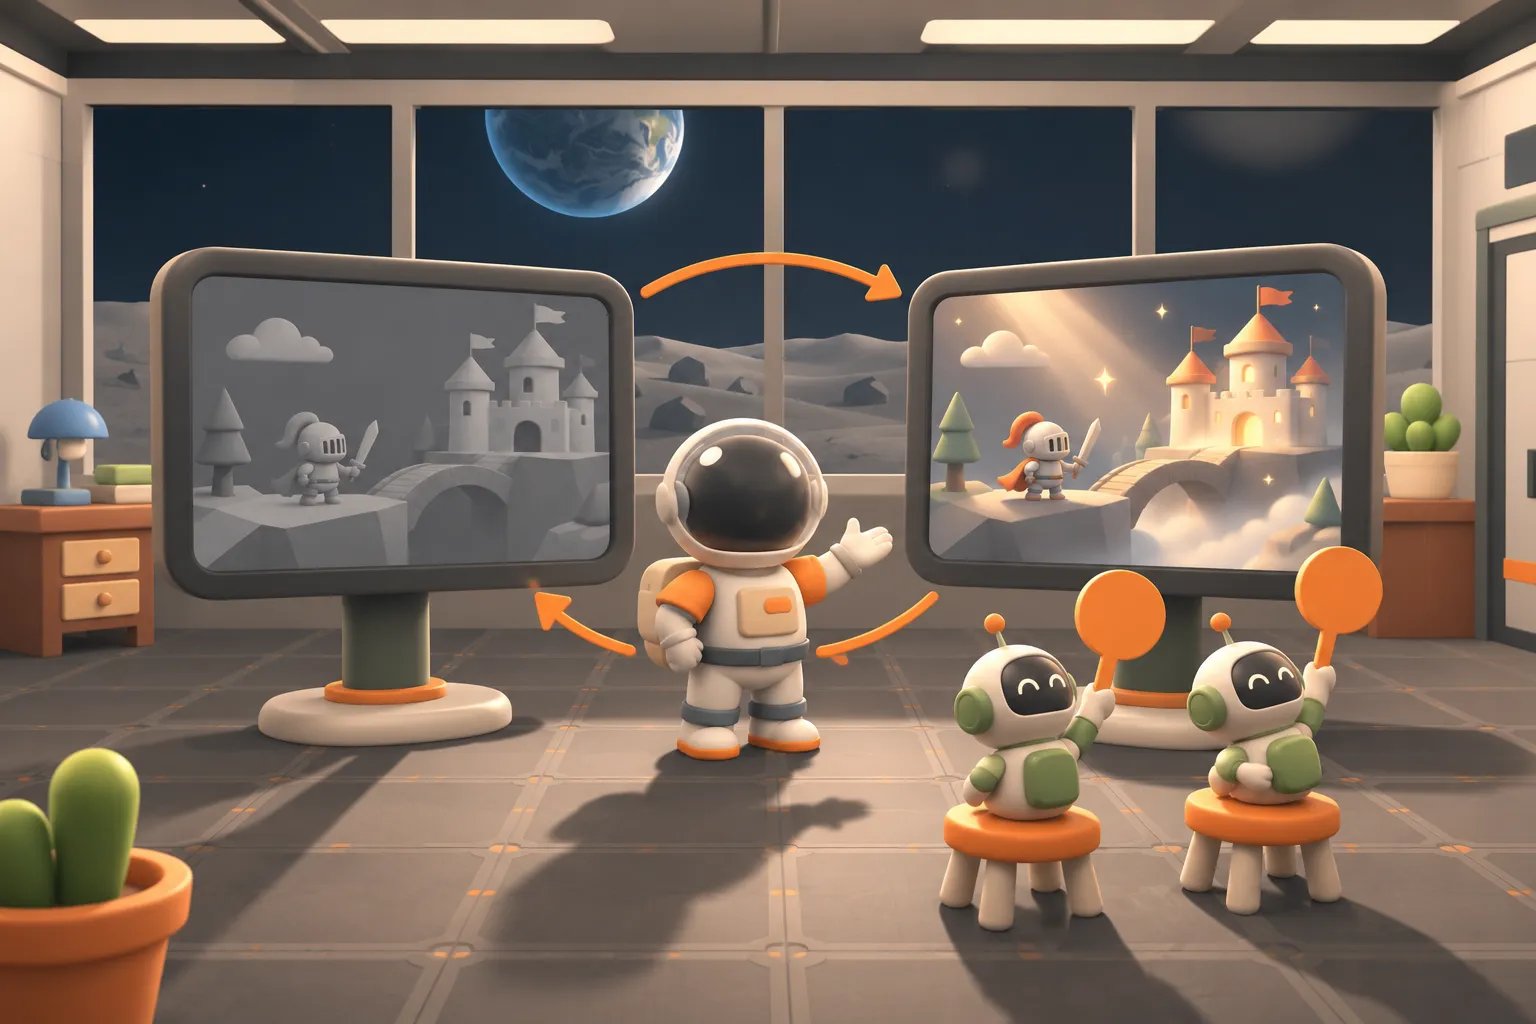
- Seedream'den bu ekran görüntüsünü yeniden çizmesini isteyin; prompt'ta kamera, kompozisyon, yerleşim ve karakter pozunun hiç değişmemesini, yalnızca görselin daha güzel çizilmesini şart koşun.
- Bu yeniden çizim "hedef görsel" oluyor; sonra yapay zeka ajanlarına ışıklandırmayı, materyalleri ve efektleri, oyun görüntüsü ona yaklaşana kadar düzelttirin.
Neden işe yarıyor? Çünkü "görüntü biraz daha güzel olsun" kabul testi yapılamayan bir cümle; aynı kameradan bir hedef görsel ise doğrudan karşılaştırılabilir: köşedeki gölge yeterince koyu mu, pencereden ışık içeri düşüyor mu, zemin yansıtıyor mu, hepsi görülebiliyor. Yapay zeka da sonunda peşinden gidebileceği somut bir yön buluyor.
Sahnedeki taşlar, çömlekler ve taş malzemeler için Poly Haven'ın ücretsiz CC0 tarama varlıklarını kullanmış; her şeyin yapay zekayla üretilmesi gerekmiyor.
Kendi denemem: Dream Loop'u ay üssünde denedim
Kendi sitemin ana sayfasındaki ay stüdyosuyla denedim. Three.js ile yapılmış bir sahne; ana karakter Terry stüdyonun ortasında duruyor, pencerenin dışında ay yüzeyi var.
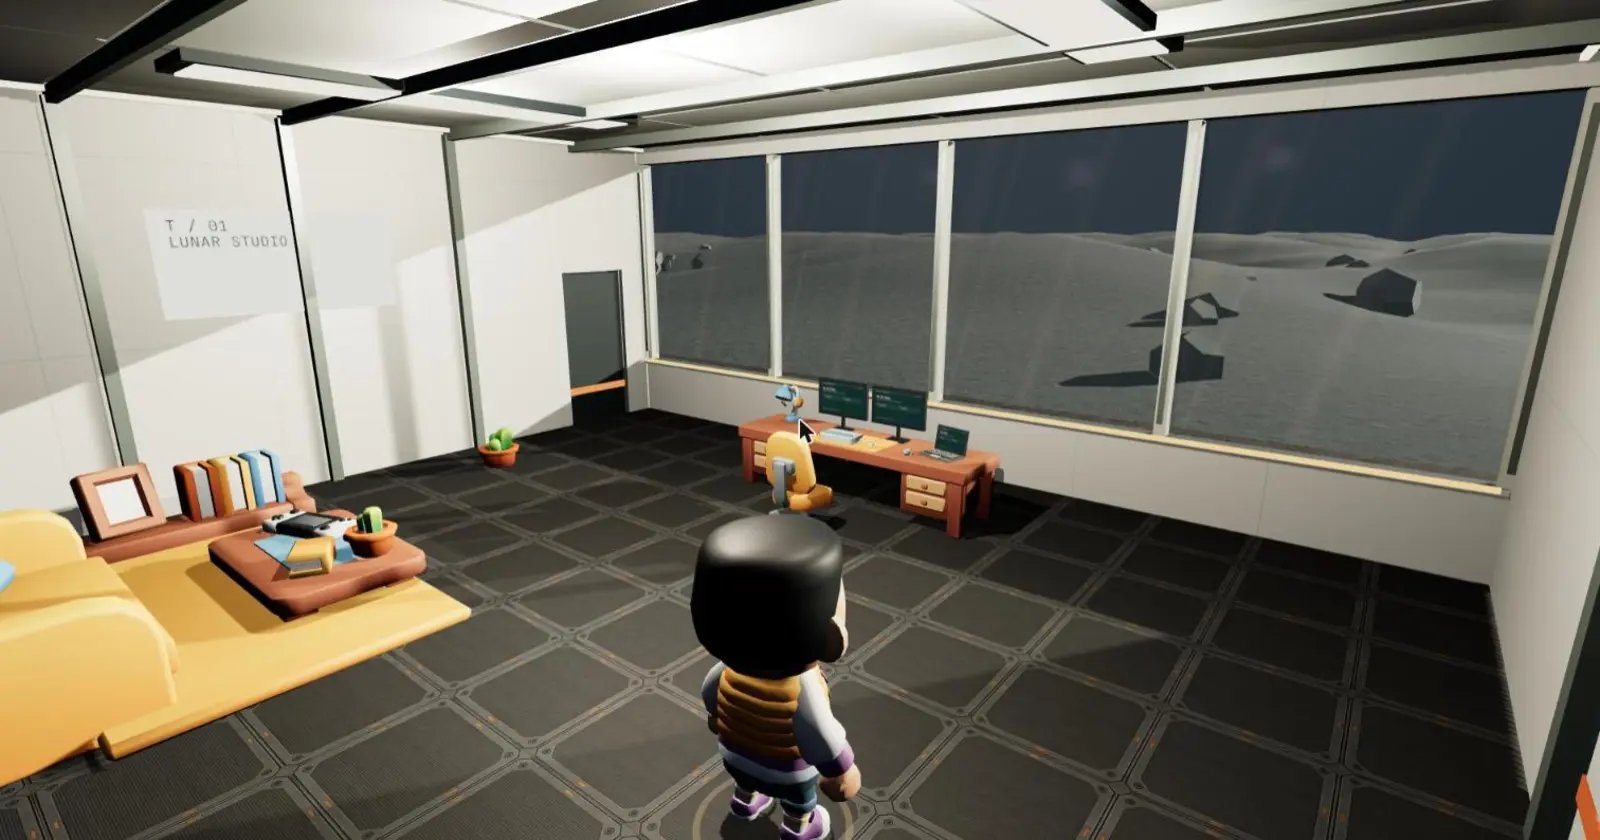
Bu ekran görüntüsünü ChatGPT'nin görsel üretimiyle (gpt-image) yeniden çizdirdim; prompt'un ana fikri Meng To'nunkiyle aynı, iki bölümden oluşuyor:
- Hiç değişmeyecekler: kamera konumu, bakış açısı, kompozisyon, her objenin yeri ve sayısı, karakterin pozu ve chibi tarzı, oda yapısı, renk paleti. Gerçekçi tarza dönmemesini özellikle yazdım.
- Sadece render değişecek: duvar köşelerine ve mobilyaların altına ambient occlusion, içeride sıcak ışık, pencereden çapraz giren soğuk ay ışığı, hafif parlayan ekranlar, biraz parlak yer karoları, pencere dışında kraterleri daha net bir ay yüzeyi ve yıldızlı bir gökyüzü, üstüne de biraz bloom ve vinyet.
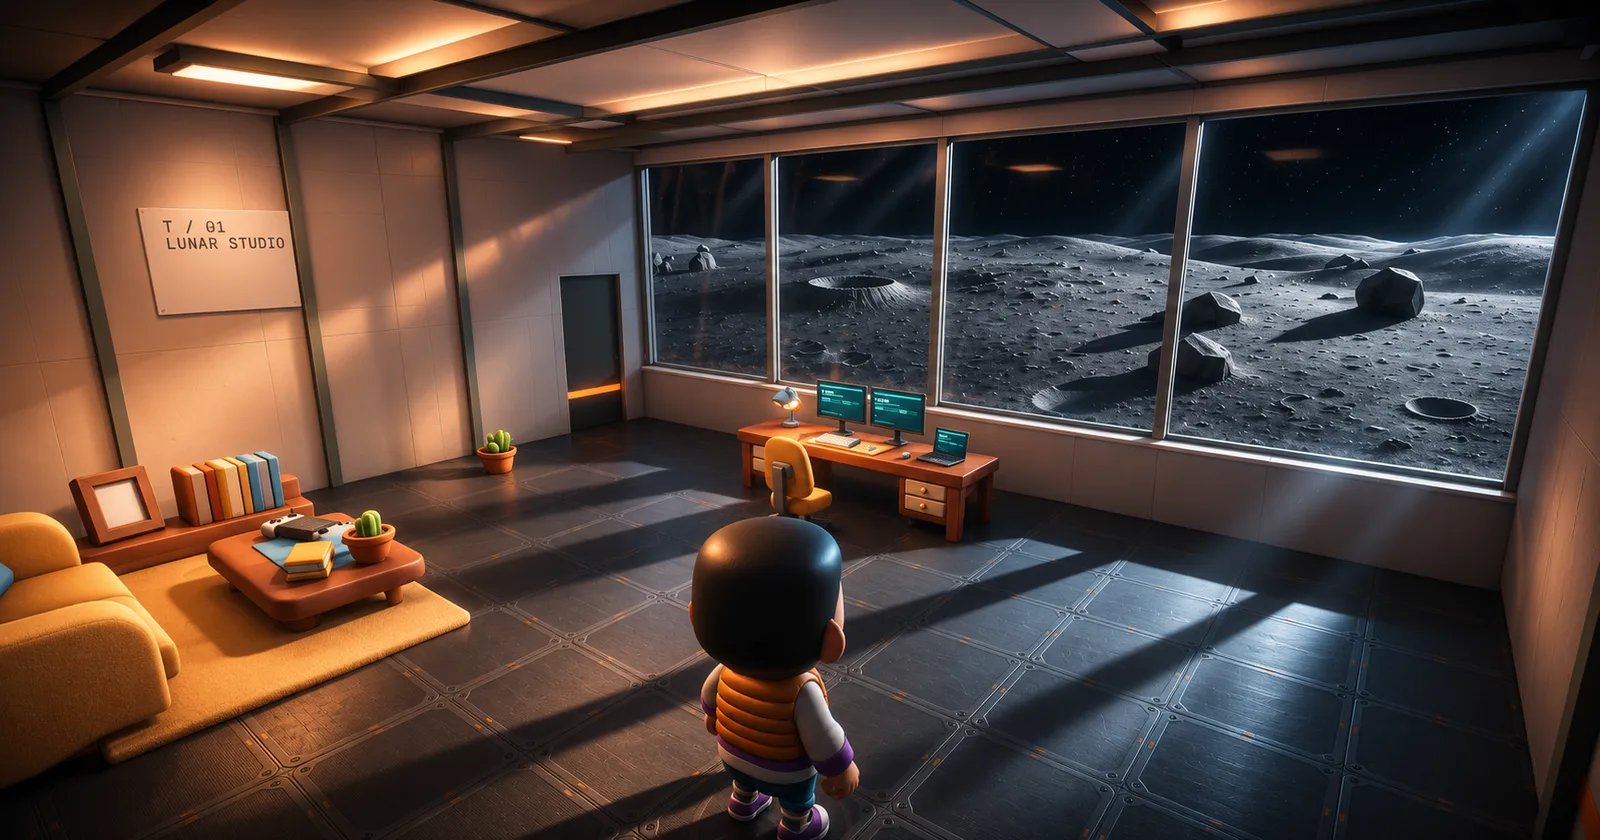
İlk denemede yön hemen belli oldu: köşelerde gölge oluştu, pencere ışığı zeminde şeritler çizdi, ay yüzeyi düz bir griden kraterli, taşlı bir araziye dönüştü. Bunların hepsi yapay zekaya doğrudan "bunun gibi yap" diyebileceğim şeyler.
Ama sorunlar da görülüyor: kamera açısı biraz genişlemiş, masa da küçülmüş. Kameraya dokunma diye açıkça yazmama rağmen görsel modeli kompozisyonu yine de sinsice değiştiriyor. Bunu hedef görsel olarak kullanmadan önce, değişmemesi gereken bir şeyin değişmediğinden emin olmak gerekiyor; bir sonraki adımdaki jürinin bu kadar önemli olmasının sebebi de bu.
Seedream ile gpt-image arasındaki fark ne?
Meng To hedef görsel için Seedream kullanıyor, ben ilk seferde gpt-image kullandım. Farkı net görmek için sonradan yeni bir ekran görüntüsü aldım; aynı görüntüyü ve aynı prompt'u hem Seedream 5.5'e hem gpt-image'a birer kez çizdirdim. Meng To, Seedream 5.0 Pro kullandı; ben ise daha yeni olan 5.5'i kullandım. Denemelerimde daha ucuz çıktı ve piksel düzeyinde hizalanacak kadar isabetliydi. Benim asıl merak ettiğim hangisinin daha güzel çizdiği değil, hangisinin kompozisyonu daha iyi koruduğu; çünkü Dream Loop'un en çok ihtiyaç duyduğu şey tam olarak bu.
Bu seferki prompt ilkinden çok daha katıydı: kompozisyonun piksel piksel hizalanması, hiçbir objenin ve kenar çizgisinin kıpırdamaması gerektiğini açıkça yazdım; ayrıca sadece Three.js'in gerçek zamanlı render ile yapabileceği efektlere izin verdim (ışık, gölge, materyal, bloom gibi), oyun motorunun yapamayacağı şeyleri çizmesini yasakladım.
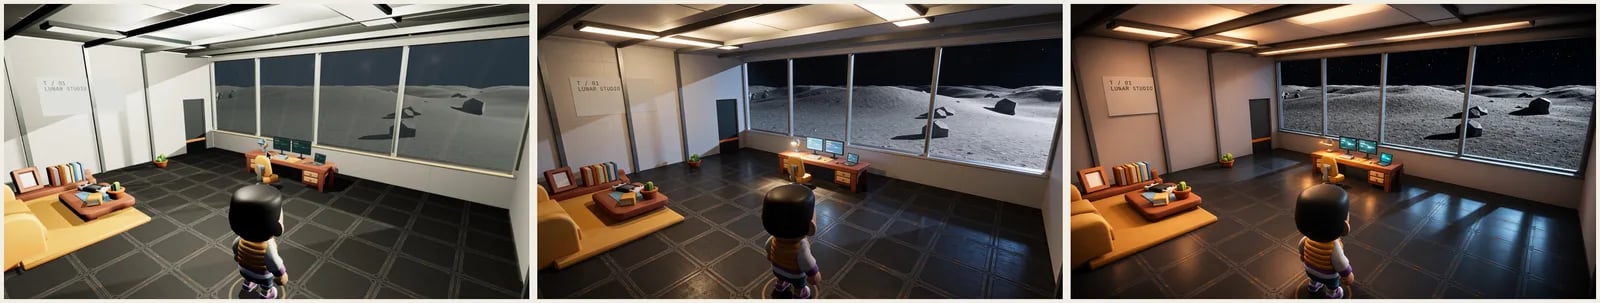
İkisi de orijinalden çok daha güzel, ama karakterleri farklı:
- Seedream 5.5 daha soğuk, daha gerçekçi: ay yüzeyi hem parlak hem net, zemin yansıtıyor, genel hava gerçek bir uzay istasyonu gibi.
- gpt-image daha sıcak, atmosferi güçlü: tavan lambaları daha sıcak, yıldızlar daha yoğun, pencere ışığı zeminde belirgin şeritler çiziyor.
Asıl farkı görmek için yeniden çizimleri orijinalin üstüne bindirmek gerekiyor:
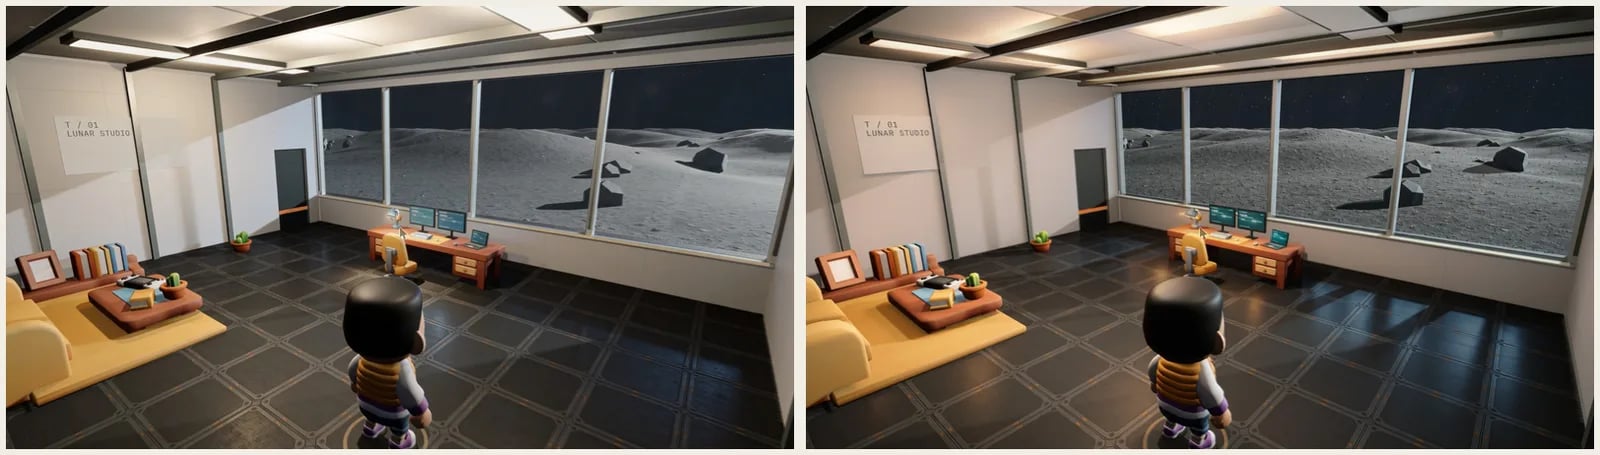
- Seedream 5.5 neredeyse piksel piksel hizalı: üst üste koyunca neredeyse hiç çift görüntü yok; pencere çerçevesi, masa, karakter yerli yerinde.
- gpt-image yakın ama biraz kayıyor: genel konumlar doğru, ama tavan ve pencere çerçevesinin kenarları hafif kaymış. gpt-image bile çizimi bitirince "kompozisyon yakın ama piksel piksel hizalı değil" diye rapor verdi.
Seedream de ilk seferde başaramadı. İlk denemede doğrudan kare bir görsel üretip görüntüyü yukarı ve aşağı uzattı, kompozisyonu baştan kurdu; girdi görselini 16:9'a kırpıp çıktı oranını da belirtince ikinci seferde hizalandı. Yani hangisini kullanırsanız kullanın, girdi ve çıktı oranını baştan netleştirin.
Benim vardığım sonuç: Dream Loop'ta hedef görsel olarak Seedream daha kullanışlı, çünkü yapay zeka ajanları her noktadaki ayrıntının peşinden gidiyor; kompozisyon biraz kayarsa bütün o çaba boşa gidiyor. gpt-image ise yön bulmak, "neye dönüşebilir" diye bakmak için iyi. Hangisini kullanırsanız kullanın, hedef görseli mutlaka orijinal ekran görüntüsüyle üst üste koyup bir kez karşılaştırın; uyuşmuyorsa yeniden çizdirin.
Adım 5: Arayüzü de yapay zekaya çizdirin
Oyun arayüzü için çok az prompt yazmış, kabaca şöyle:
- Önce ekranın altındaki can ve dayanıklılık barları dahil tüm arayüzün konsept çizimini istemiş.
- Ona göre yapmasını söylemiş.
- Yeterince kaliteli bulmayınca çerçevelere daha fazla gradyan, düzensizlik, gölge ve gren istemiş.
- En sonda ikonları şeffaf PNG olarak istemiş.
İkonlar da Seedream'in çizdiği şeffaf PNG'ler.
Adım 6: Her değişikliği kör testten geçirin
Dream Loop'un kontrolden çıkmamasının anahtarı bu. Kuralları şöyle:
- Her değişiklikte, aynı kameradan 4K bir önce ve bir sonra görüntüsü alınıyor.
- Bunlar tamamen yeni bir yapay zeka jürisine veriliyor; iki görselin sırası karıştırılıp sadece X ve Y olarak etiketleniyor, jüri hangisinin yeni olduğunu bilmiyor.
- Değişiklik ancak yeni sürüm kazanırsa ya da berabere kalırsa tutuluyor.
- Tam bir tur için iki jüri üyesi ve 10 üzerinden bir puanlama tablosu kullanılıyor, düşük olan puan alınıyor; hedef 9.
Yapay zeka ajanları "düzelttim" demekte çok başarılı, ama kendi değiştirip kendi onayladıklarında iş genelde gittikçe yamuluyor. Süreci hiç görmemiş bir jüri getirip sırayı karıştırmak, görüntü kalitesi için regresyon testi yapmak gibi; kötüleştiren değişiklikler kalamıyor.
Kendi verdiği komutlar da çok kısa, kabaca "8 puana ulaşana kadar düzeltmeye devam et", "her seferinde önce/sonra ekran görüntüsü ver, animasyonlar için video ver" gibi. Bir keresinde boss'un kılıç darbesi efekti bir türlü düzelmeyince verdiği yanıtta sabırsızlığı açıkça belli oluyordu; demek ki ne kadar iyi bir süreç olursa olsun yine de takılınan yerler oluyor.
Yapay zeka ile oyun yapmak mümkün mü? Bu yöntemin sınırları
Meng To da bunun henüz bitmiş bir oyun olmadığını açıkça söylüyor:
- Videoda oyunu bir betikle kontrol edilen bot oynuyor, her sahne önceden ayarlanmış.
- Katı jüriler çoğunlukla sadece 5 ile 6 arası puan veriyor, 9'dan hâlâ çok uzak.
- Yükleme 10 saniyeden uzun sürüyor.
- En zoru yürüme ve koşma animasyonları; yorumlarda en az 8 kez denediğini, yürümeyi 4 kez reddettiğini söylüyor.
Yani üç günde ortaya çıkan şey oynanabilir bir demo, mağazaya konacak bir oyun değil. Ama tek başına oyun yapan biri için sıfırdan bu seviyeye üç günde gelmek zaten inanılmaz.
Yapay zeka ile tek başına oyun yapıyorsanız önce hangi numaraları öğrenmelisiniz?
Siz de yapay zekayla oyun yapıyorsanız, bence ilk alıp kullanmaya değer üç şey şunlar:
- "Güzel"i tek bir görselle tanımlayın: ekran görüntüsü al, yeniden çizdir, hedef yap; uzun bir stil tarifi yazmaktan çok daha isabetli.
- Onayı başkasına verdirin: değişiklik öncesi ve sonrası aynı kameradan görüntü alıp yeni bir yapay zekaya kör seçim yaptırın; değiştirenin kendi kendine puan vermesine izin vermeyin.
- Bir şef, birkaç uzman ajan: her ajan yalnızca kendi dosyalarına dokunursa gönül rahatlığıyla paralel çalıştırabilirsiniz.
Benim bir sonraki adımım, denemedeki o hedef görsele göre ay stüdyosunun ışıklandırmasını düzeltmek; her değişiklikte önce/sonra görüntülerini jüriye seçtirip gerçekten o görsele yaklaşıp yaklaşamayacağımı görmek.
Siz de yapay zekaya görüntünün daha iyi olup olmadığını kendi başına değerlendirtmeyi denediniz mi? Threads ya da X üzerinden gönderilerimin altına yorum bırakabilirsiniz, sohbet edelim.